Cómo detectamos un problema crítico en producción en minutos usando APM
Descubre cómo detectamos y resolvimos un problema crítico en producción en minutos usando APM, evitando impacto en usuarios y pérdidas para el negocio.
Insoftar, detección con APM
El problema: una aplicación “funcionando”… pero usuarios afectados
Una empresa con una aplicación crítica comenzó a recibir reportes de usuarios:
- Lentitud en una funcionalidad clave
- Tiempos de respuesta inconsistentes
- Experiencia degradada en horarios pico
Desde infraestructura todo parecía normal:
- CPU estable
- Memoria sin saturación
- Sin caídas evidentes
El problema no era visible a simple vista.
El riesgo: impacto directo en el negocio
Esta funcionalidad estaba directamente relacionada con:
- Transacciones de usuarios
- Conversión de ventas
- Experiencia del cliente
Cada minuto con degradación significaba:
- Pérdida de ingresos
- Frustración de usuarios
- Posible abandono de la plataforma
El enfoque: usar APM para entender lo que realmente pasaba
En lugar de revisar logs manualmente o hacer pruebas a ciegas, se utilizó APM para analizar el comportamiento en tiempo real.
El objetivo era claro:
Identificar exactamente dónde estaba el cuello de botella.
Lo que encontramos en minutos
A través del APM se logró:
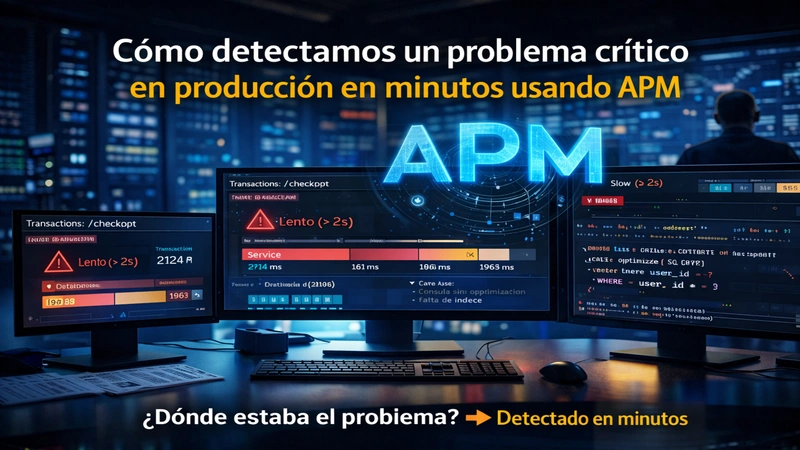
Identificar una transacción lenta
Una operación específica tenía tiempos de respuesta superiores a lo normal.
Ubicar el punto exacto del problema
El retraso no estaba en la aplicación en sí, sino en una consulta a base de datos.
Medir el impacto real
- Tiempo promedio esperado: ~200 ms
- Tiempo actual: >2 segundos
Analizar la trazabilidad completa
Se pudo seguir el flujo completo:
Usuario → API → Servicio → Base de datos
El problema estaba claramente localizado.
La causa raíz
Al profundizar en el análisis se identificó:
- Una consulta sin optimización
- Falta de índices adecuados
- Crecimiento de datos no considerado
Esto generaba un cuello de botella en momentos de alta carga.
La solución
Se aplicaron ajustes puntuales:
- Creación de índices en la base de datos
- Optimización de la consulta
- Validación de tiempos en tiempo real
El resultado
Después de la corrección:
- Tiempo de respuesta volvió a ~200 ms
- Eliminación de la lentitud percibida por usuarios
- Estabilidad durante picos de tráfico
Todo el proceso (detección + diagnóstico + solución) tomó menos de una hora.
¿Qué hubiera pasado sin APM?
Sin visibilidad:
- Horas (o días) revisando logs
- Pruebas manuales sin certeza
- Diagnóstico basado en suposiciones
El impacto al negocio habría sido mucho mayor.
Lecciones clave
1. No todo problema es de infraestructura
Muchas veces el problema está en la lógica o en la base de datos.
2. La visibilidad lo cambia todo
Entender el flujo completo permite tomar decisiones rápidas.
3. El tiempo de respuesta es crítico
Pequeñas degradaciones impactan directamente al usuario.
4. El APM no es opcional
En aplicaciones modernas, es una necesidad.
Conclusión
Las aplicaciones actuales son cada vez más complejas:
- Microservicios
- Integraciones externas
- Alto volumen de usuarios
En este contexto, detectar problemas sin herramientas adecuadas es cada vez más difícil.
El APM permite pasar de:
“creemos que el problema está aquí” a “sabemos exactamente dónde está el problema”
¿Qué tan visible es tu aplicación hoy?
Si no puedes identificar en minutos dónde está un problema en producción, probablemente necesitas mejorar tu nivel de observabilidad.
Detectar antes de que el usuario se queje no es un lujo… es una ventaja competitiva.