Qué métricas realmente importan en observabilidad
Las métricas correctas permiten entender el comportamiento real de tus sistemas, detectar problemas y mejorar la experiencia del usuario en observabilidad.
No necesitas más métricas… necesitas las correctas
Uno de los errores más comunes en observabilidad es este:
medir todo
- CPU
- memoria
- disco
- red
- cientos de dashboards
Pero al final:
- No sabes qué es importante
- No puedes tomar decisiones
- No detectas problemas reales
Tener datos no es lo mismo que tener visibilidad.
¿Qué es una métrica en observabilidad?
Una métrica es un valor numérico que representa el comportamiento de un sistema en el tiempo.
Ejemplos:
- Tiempo de respuesta
- Número de solicitudes
- Tasa de errores
- Uso de recursos
Las métricas permiten entender cómo se comporta tu sistema.
El problema: métricas sin contexto
Muchas organizaciones miden:
- CPU alta
- Memoria al límite
Pero no saben responder:
¿Esto afecta al usuario?
¿Esto impacta el negocio?
Sin contexto, las métricas no sirven.
Las métricas que realmente importan
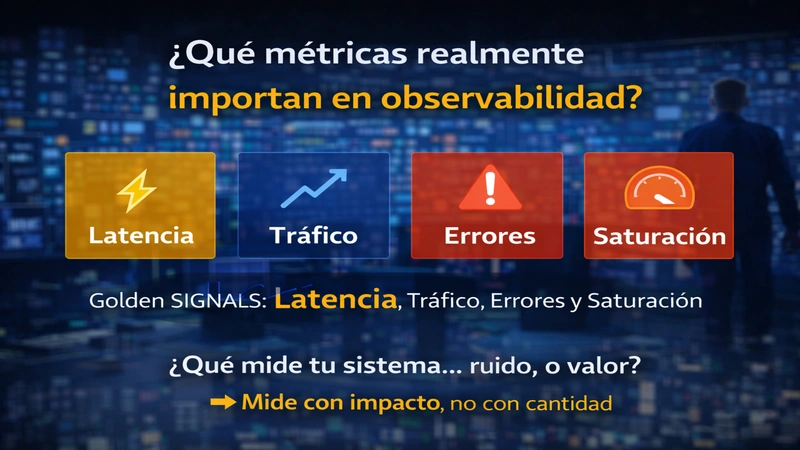
Para simplificar, existen cuatro métricas clave conocidas como:
Golden Signals
1. Latencia (Latency)
Tiempo que tarda el sistema en responder.
Es lo que el usuario percibe directamente.
Ejemplo:
- Una API responde en 200 ms vs 3 segundos
Impacto: experiencia del usuario.
2. Tráfico (Traffic)
Cantidad de solicitudes o usuarios.
Ejemplo:
- Número de peticiones por segundo
- Usuarios activos
Impacto: demanda del sistema.
3. Errores (Errors)
Porcentaje de solicitudes que fallan.
Ejemplo:
- HTTP 5xx
- errores en frontend
- fallos de integración
Impacto: confiabilidad.
4. Saturación (Saturation)
Nivel de uso de recursos.
Ejemplo:
- CPU
- memoria
- conexiones
Impacto: capacidad del sistema.
¿Por qué estas métricas son clave?
Porque responden a preguntas fundamentales:
- ¿El sistema responde rápido?
- ¿Está recibiendo carga?
- ¿Está fallando?
- ¿Está cerca del límite?
Con estas cuatro, tienes una visión clara.
Más allá de las Golden Signals
Dependiendo del negocio, puedes incluir:
Métricas de negocio
- Conversiones
- transacciones
- ingresos
Métricas de experiencia
- tiempo de carga en frontend
- interacción del usuario
Métricas de integración
- tiempos de APIs externas
- fallos en servicios terceros
La clave: alinear métricas con impacto real.
Un ejemplo práctico
Aplicación de e-commerce:
Métricas técnicas:
- Latencia de API
- tasa de errores
Métricas de negocio:
- conversiones
- abandono de carrito
Si la latencia sube:
- baja la conversión
- impacto directo en ingresos
Buenas prácticas
- Medir menos, pero mejor
- Priorizar métricas con impacto
- Relacionar métricas técnicas con negocio
- Definir umbrales y objetivos (SLO)
- Visualizar de forma clara
Errores comunes
- Medir todo sin priorizar
- Enfocarse solo en infraestructura
- Ignorar el frontend
- No correlacionar métricas
- No actuar sobre los datos
Cómo se integra con la observabilidad
Las métricas trabajan junto a:
- Logs → contexto
- Trazas → detalle de flujo
- RUM → experiencia real
- Alertas → acción
Las métricas son el “pulso” del sistema.
Conclusión
La observabilidad no se trata de recolectar datos.
Se trata de entender lo que realmente importa.
Las métricas correctas permiten:
- Detectar problemas
- Priorizar acciones
- Mejorar la experiencia
- Impactar el negocio
¿Estás midiendo lo importante… o solo lo disponible?
Si no sabes qué métricas son críticas, es probable que estés viendo ruido en lugar de valor.
Y en observabilidad: menos es más… cuando mides bien.